Wie aus Claude Klaus wurde — ein Sprachmodell als Kollege, und die Dateien, die es dazu machen
Ein Sprachmodell vergisst nach jeder Sitzung alles. Wie man trotzdem dauerhaft mit ihm arbeitet: ein Werkstattbericht über Claude, Obsidian und Bonsai, verbunden über MCP, und über die wenigen Dateien, die aus einem Werkzeug einen Kollegen machen.

Dieser Text beschreibt, wie ich mit einem Sprachmodell arbeite, und vor allem, wie das System darum herum aufgebaut ist. Das Sprachmodell ist Claude von Anthropic. Es liest und schreibt in meinen Notizen, die in Obsidian liegen, und es arbeitet im BIM-Modell, das in Bonsai offen ist. Beide Verbindungen laufen über das Model Context Protocol, kurz MCP. Das allein wäre eine Werkzeugliste. Worum es mir geht, ist die Schicht darüber: die Handvoll Dateien, die dafür sorgen, dass eine Arbeit über Wochen und über viele Sitzungen hinweg zusammenhält, obwohl das Sprachmodell zwischen zwei Sitzungen alles vergisst.
Was Sie hier sehen, ist das Prinzip, nicht meine Ablage. Die Ordner und Dateien in diesem Text gehören zu einem erfundenen Projekt, dem Anbau einer Kindertagesstätte. Die Regeln dagegen sind echt; jede davon hat einen Anlass, und einige dieser Anlässe waren unangenehm. Ein Messbericht ist das nicht. Es ist ein Werkstattbericht, und er beschreibt den Stand vom Oktober 2026.
Klaus
Irgendwann habe ich angefangen, Claude Klaus zu nennen. Nicht aus Bequemlichkeit, sondern weil sich die Arbeit so anfühlte: wie mit einem Mitarbeiter, den man schätzt. Klaus hat unendlich Geduld. Er erklärt zum fünften Mal, warum ein Vorzeichen in einer Georeferenzierung so herum steht und nicht anders, und er tut es beim fünften Mal so freundlich wie beim ersten. Er hat fast immer einen Trick auf Lager, wenn ein Werkzeug sich sperrt. Und er vergisst nichts.
Der letzte Satz stimmt nur, weil ich dafür gesorgt habe. Von sich aus vergisst Klaus alles. Jede Sitzung mit einem Sprachmodell beginnt bei null: Was gestern entschieden wurde, welcher Versuch gescheitert ist, welche Frage noch offen steht, weiß er nicht. Er weiß es nur, wenn es irgendwo steht und er es liest. Ein Kollege, der jeden Morgen ohne Erinnerung ins Büro kommt, ist trotzdem ein guter Kollege, wenn auf seinem Schreibtisch ein Zettel liegt, der sagt, wo er aufgehört hat, und eine Mappe, in der steht, warum.
Dieser Text handelt von dem Zettel und der Mappe.
Drei Programme und ein Protokoll
Der technische Teil ist schnell erzählt.
Claude ist das Sprachmodell, mit dem ich spreche, in der Desktop-Anwendung von Anthropic. Es führt das Gespräch, schlägt vor, schreibt Texte und Skripte und ruft Werkzeuge auf.
Obsidian ist ein Notizprogramm, das auf einem gewöhnlichen Ordner mit Textdateien arbeitet. Jede Notiz ist eine Markdown-Datei, also lesbarer Text mit ein paar Satzzeichen für Überschriften und Hervorhebungen. Obsidian nennt einen solchen Ordner Vault. Notizen verweisen mit doppelten eckigen Klammern aufeinander, und Obsidian hält diese Verweise beim Umbenennen nach. Für die Arbeit mit einem Sprachmodell zählt vor allem eines: Alles liegt als Text vor, den Mensch und Maschine gleich gut lesen.
Blender mit Bonsai ist das BIM-Autorenwerkzeug. Bonsai ist eine Erweiterung für Blender, die IFC-Dateien nativ bearbeitet, also das offene Austauschformat für Bauwerksmodelle.
Verbunden sind die drei über MCP, das Model Context Protocol. Es ist ein offenes Protokoll, über das ein Sprachmodell Werkzeuge aufrufen kann, die ein anderes Programm bereitstellt. Das Programm meldet, welche Werkzeuge es anbietet, etwa Datei lesen, Abschnitt ersetzen, alle Türen im Modell auflisten, und das Sprachmodell entscheidet im Gespräch, wann es welches aufruft.
Auf der Obsidian-Seite bringt das Gemeinschafts-Plugin Local REST API einen solchen Server gleich mit, unter MIT-Lizenz. Die Desktop-Anwendung von Claude erreicht ihn über die Brücke mcp-remote, so wie es die Dokumentation des Plugins beschreibt. Auf der Bonsai-Seite ist es Bonsai_mcp von Jota de Rodriguez, ein eigenständiges Gemeinschaftsprojekt. Keines davon stammt von mir; alle laufen auf meinem Rechner, und Obsidian beziehungsweise Blender müssen geöffnet sein, damit Claude sie erreicht.

Eine Eigenheit verdient einen eigenen Satz, weil sie das ganze System prägt. Der Bonsai-Server kann beliebigen Python-Code im laufenden Blender ausführen, liefert aber dessen Ausgabe nicht an das Sprachmodell zurück. Jedes Skript schreibt sein Ergebnis deshalb in eine Datei im Vault, und Claude liest diese Datei danach über Obsidian. Was zuerst wie ein Umweg aussah, ist zur Regel geworden: Gelesen wird aus der geschriebenen Datei, nicht aus dem, was eine Schnittstelle meldet. Eine Meldung sagt, was ein Programm zu tun glaubte. Die Datei zeigt, was es getan hat.
Das Gedächtnis liegt in Dateien
Damit ist die eigentliche Frage gestellt: Wenn das Sprachmodell nichts behält, muss der Vault es behalten, und zwar so, dass eine neue Sitzung in wenigen Minuten weiß, wo die Arbeit steht. Ein gewöhnlicher Projektordner leistet das nicht. Er enthält die Ergebnisse, aber nicht den Weg dorthin, nicht die offenen Fragen und nicht die Gründe.
So sieht der Vault des erfundenen Kita-Anbaus aus:
Kita_Anbau/
├── 00_Was_jetzt_ansteht.md        ← ein Blick über alle Bereiche
├── 100_Planung/
│   ├── README.md                  ← Spielregeln und Betriebsanleitung
│   ├── 00_Ops/
│   │   ├── Wiedereinstieg.md      ← der Haltepunkt: was ist der nächste Schritt?
│   │   ├── Klaerung.md            ← Fragen an mich, Zähler K
│   │   ├── Projektstatus.md       ← die Ampel je Arbeitspaket
│   │   └── Entscheidungslog.md    ← wer was warum entschieden hat, Zähler E
│   ├── 10_Raumprogramm/
│   ├── 20_Modell/
│   ├── 30_Brandschutz/
│   └── 90_Prompts/
│       └── Sitzungsstart.md       ← der Text, mit dem eine Sitzung beginnt
└── 200_Ausschreibung/
    ├── README.md
    ├── 00_Ops/                    ← dieselben vier Dateien, eigene Zähler
    └── …
Die Fachordner, hier Raumprogramm, Modell und Brandschutz, sind die Arbeit selbst. Interessant sind die anderen Dateien. Sie tragen nichts zum Projekt bei, außer dass es weitergeht.
Die README: Spielregeln für Menschen, Betriebsanleitung für die Maschine
Jeder Bereich hat eine README, und sie hat zwei Teile. Der erste richtet sich an Menschen: worum es in diesem Bereich geht, welche Quellen verwendet werden dürfen und welche nicht, wie die Ordner heißen. Der zweite richtet sich an das Sprachmodell: in welcher Reihenfolge es beim Einstieg liest, was es vor jedem Ergebnis prüft, was es nie tut.
Der zweite Teil wächst. Jede Regel darin ist einmal gebrochen worden, und unter vielen steht der Anlass. Das ist Absicht. Eine Regel ohne Anlass wird beim nächsten Aufräumen gestrichen, weil niemand mehr weiß, wofür sie gut war. Eine Regel mit Anlass verteidigt sich selbst.
Der Wiedereinstieg: ein Haltepunkt, nicht mehrere
Diese Datei beantwortet genau eine Frage: Was ist der nächste Schritt? Oben steht ein einziger Haltepunkt mit Datum: was in der letzten Sitzung entstanden ist, was als Nächstes zu tun ist, was offen bleibt. Darunter steht eine Kurzfassung älterer Tage, je Tag ein Absatz.
Die wichtigste Regel dieser Datei lautet: ein Haltepunkt, nicht mehrere gestapelte. Beginnt eine Sitzung, und der oberste Haltepunkt ist von einem früheren Tag, wird er zuerst in die Kurzfassung verdichtet. Wer Haltepunkte stapelt, hat nach einer Woche fünf nächste Schritte, von denen drei erledigt sind, und niemand weiß, welche.
Die Klärung: Fragen, die nur ich beantworten kann
Klaus darf vieles entscheiden: wie ein Skript aufgebaut ist, in welcher Reihenfolge er liest, wie er einen Befund formuliert. Er darf nicht entscheiden, was nur der Planer entscheiden kann. Ob die Türen zum Flur eine Feststellanlage bekommen, ob ein Raum im Raumprogramm gestrichen wird, ob eine Quelle öffentlich verwendet werden darf: Das steht als nummerierter Punkt in der Klärungsdatei, mit dem, was er weiß, und dem, was er nicht weiß.
Ich antworte direkt darunter, in einem Kommentar, den Obsidian beim Lesen ausblendet: zwischen zwei Paaren von Prozentzeichen. Die nächste Sitzung liest die Kommentare mit, arbeitet die Antwort ein und entfernt den Punkt. Erledigt heißt entfernt, nicht abgehakt. Eine Klärungsdatei mit vierzig abgehakten Punkten versteckt die drei offenen. Damit dabei nichts verloren geht, wandert der Wortlaut des Punktes vorher ins Entscheidungslog.
Das Entscheidungslog: geschrieben wird viel, gelesen fast nie
Das Log ist die Mappe auf dem Schreibtisch. Jede Entscheidung bekommt eine durchlaufende Nummer, ein Datum, den Anlass und eine Liste der Dateien, die dabei geändert wurden. Es wird nur ergänzt, nie umgeschrieben; eine spätere Berichtigung ist ein neuer Eintrag, der auf den alten verweist.
Und es wird beim Wiedereinstieg nicht gelesen. Das klingt widersinnig, ist aber der Grund, warum das System trägt. Das Log wird schnell lang: In dem Bereich, aus dem dieser Text stammt, sind zwischen dem 3. September und dem 14. Oktober 2026 287 Einträge entstanden. Läse jede Sitzung das ganze Log, wäre sie vom Lesen erschöpft, bevor sie anfängt. Gelesen wird es auf eine bestimmte Frage hin: Warum ist das so entschieden worden? Dann hat die Nummer ihren Wert. Wer in einer anderen Datei „siehe E112" liest, findet den Grund in einer Minute.
Der Projektstatus und der Blick über alles
Der Projektstatus ist eine Ampel je Arbeitspaket, mehr nicht. Er ist für mich, wenn ich wissen will, wo das Projekt steht, ohne eine Sitzung zu beginnen.
In der Wurzel des Vaults liegt eine Datei, die über alle Bereiche schaut: je Bereich höchstens zwei Zeilen, mit nächstem Schritt, einer Ampel, wer dran ist, und dem Datum. Sie ist ein Zeiger, kein Speicher. Was dort steht, steht ausführlich im Haltepunkt des Bereichs; die Wurzeldatei sagt nur, wo man nachsehen muss.
Der Sitzungsprompt: ersetzt, nicht ergänzt
Eine Sitzung beginnt mit einem Text, den ich in das Gespräch einfüge: welcher Bereich, welche Dateien zuerst, welche Regeln gelten, was nicht gelesen wird. Am Ende der Sitzung schreibt Klaus ihn neu, für die nächste. Ersetzt, nicht ergänzt — sonst beschreibt der Prompt nach drei Wochen einen Stand, den es nicht mehr gibt, und die neue Sitzung glaubt ihm.
Und selbst der ersetzte Prompt ist nur eine Beschreibung. Dazu gleich mehr.
Zwei Bereiche, eine Richtung
Der Kita-Vault hat zwei Bereiche: die Planung und die Ausschreibung. Die Ausschreibung braucht die Planung, sie liest Raumprogramm und Modell. Umgekehrt nicht. Verwiesen wird nur in eine Richtung: Die Ausschreibung darf auf die Planung zeigen, die Planung zeigt nie auf die Ausschreibung. Findet die Arbeit an der Ausschreibung einen Fehler in der Planung, wird er dort gemeldet, wo er abgearbeitet wird, in der Klärung der Planung, aber ohne Verweis zurück.
Das wirkt pedantisch und hat zwei handfeste Gründe. Jeder Bereich hat seine eigenen Steuerdateien und eigene Zähler, und eine Sitzung im einen Bereich soll nicht in die Dateien des anderen schreiben. Und ein Bereich, auf den nichts zeigt, lässt sich später herauslösen, ohne dass anderswo ein Verweis ins Leere läuft.
Eine Zahl gehört übrigens an genau eine Stelle. Steht die Bruttogeschossfläche im Raumprogramm und noch einmal im Projektstatus, ist eine der beiden irgendwann falsch, und meistens die, die gerade gelesen wird. Die andere Datei verweist auf die eine.
Eine Sitzung, von Anfang bis Ende
So sieht eine gewöhnliche Sitzung im erfundenen Projekt aus.

Der Anfang ist Lesen. Ich füge den Sitzungsprompt ein. Klaus liest den Haltepunkt der Planung: Türliste aus dem Modell ziehen und gegen das Brandschutzkonzept halten. Offen: K4, welche Türen eine Feststellanlage bekommen. Er liest die Klärungsdatei ganz, auch die Kommentare, und findet unter K4 meine Antwort: alle Türen der Gruppenräume zum Flur. Er liest die README des Bereichs. Das Log liest er nicht.
Steht im Prompt etwas anderes als in den Dateien, gilt die Datei. Hätte der Prompt behauptet, K4 sei noch unbeantwortet, wäre das nur eine veraltete Beschreibung gewesen. Ein Prompt beschreibt einen Stand, die Datei ist der Stand. Klaus sagt die Abweichung trotzdem, damit ich sie sehe.
Dann die Arbeit. Klaus trägt die Antwort aus K4 ins Brandschutzkonzept ein, kopiert den Wortlaut von K4 ins Log und entfernt den Punkt. Danach schreibt er ein kurzes Skript für Bonsai, das alle Türen des Modells mit Raum, Breite und dem Merkmal Feststellanlage in eine Datei schreibt, lässt es im laufenden Blender ausführen und liest die Datei über Obsidian. Sieben Gruppenraumtüren, fünf mit dem Merkmal, zwei ohne.
Hier entscheidet sich, ob man einen Kollegen hat oder ein Werkzeug, das Fehler schneller macht. Die naheliegende Reaktion wäre, das Merkmal an den zwei Türen zu setzen. Klaus setzt es nicht. Er sieht nach: Die zwei Türen führen nicht in den Flur, sondern in den Garten. Und er folgt dem Verweis auf die Notiz Gartentüren zurück und findet dort, was ich längst vergessen hatte: einen Eintrag im Log, E37, Wochen alt, nach dem diese Türen der zweite Rettungsweg der Gruppenräume sind. Ob meine Antwort zum Flur sie einschließen sollte, weiß er trotzdem nicht. Also wird daraus K5, mit den Türnummern, dem Befund, dem Hinweis auf E37 und der Frage. Bei Unklarheit fragen, nicht auflösen — aber mit allem, was schon entschieden ist, auf dem Tisch.
Am Ende wird geschrieben. Ein Eintrag ins Log mit der nächsten freien Nummer, die er am Ende der Datei nachsieht und nicht aus dem Gedächtnis übernimmt, darunter die Liste der geänderten Dateien. Ein neuer Haltepunkt, der alte wandert in die Kurzfassung. K5 in die Klärung. letzte_aktualisierung in jeder berührten Datei. Die Zeile der Planung in der Wurzeldatei. Und ein neuer Sitzungsprompt.
Das klingt nach viel Verwaltung für eine Türliste. Es dauert wenige Minuten, und Klaus erledigt es selbst. Der Ertrag zeigt sich in der nächsten Sitzung, die in einer Woche beginnt, mit einem Sprachmodell, das von all dem nichts weiß, und die nach vier Dateien genau dort weitermacht.
Der Faden
Obsidian zeigt einen Vault auf Wunsch als Graph: jede Notiz ein Punkt, jeder Verweis eine Linie. Das Bild ist schön, und es zeigt etwas, das man beim Arbeiten nicht sieht. Alles hängt mit allem zusammen. Die Türliste mit dem Brandschutzkonzept, das Brandschutzkonzept mit den Rettungswegen, die Rettungswege mit einer Entscheidung, die vor Wochen gefallen ist, und diese Entscheidung mit einer Frage, die erst heute gestellt wird.
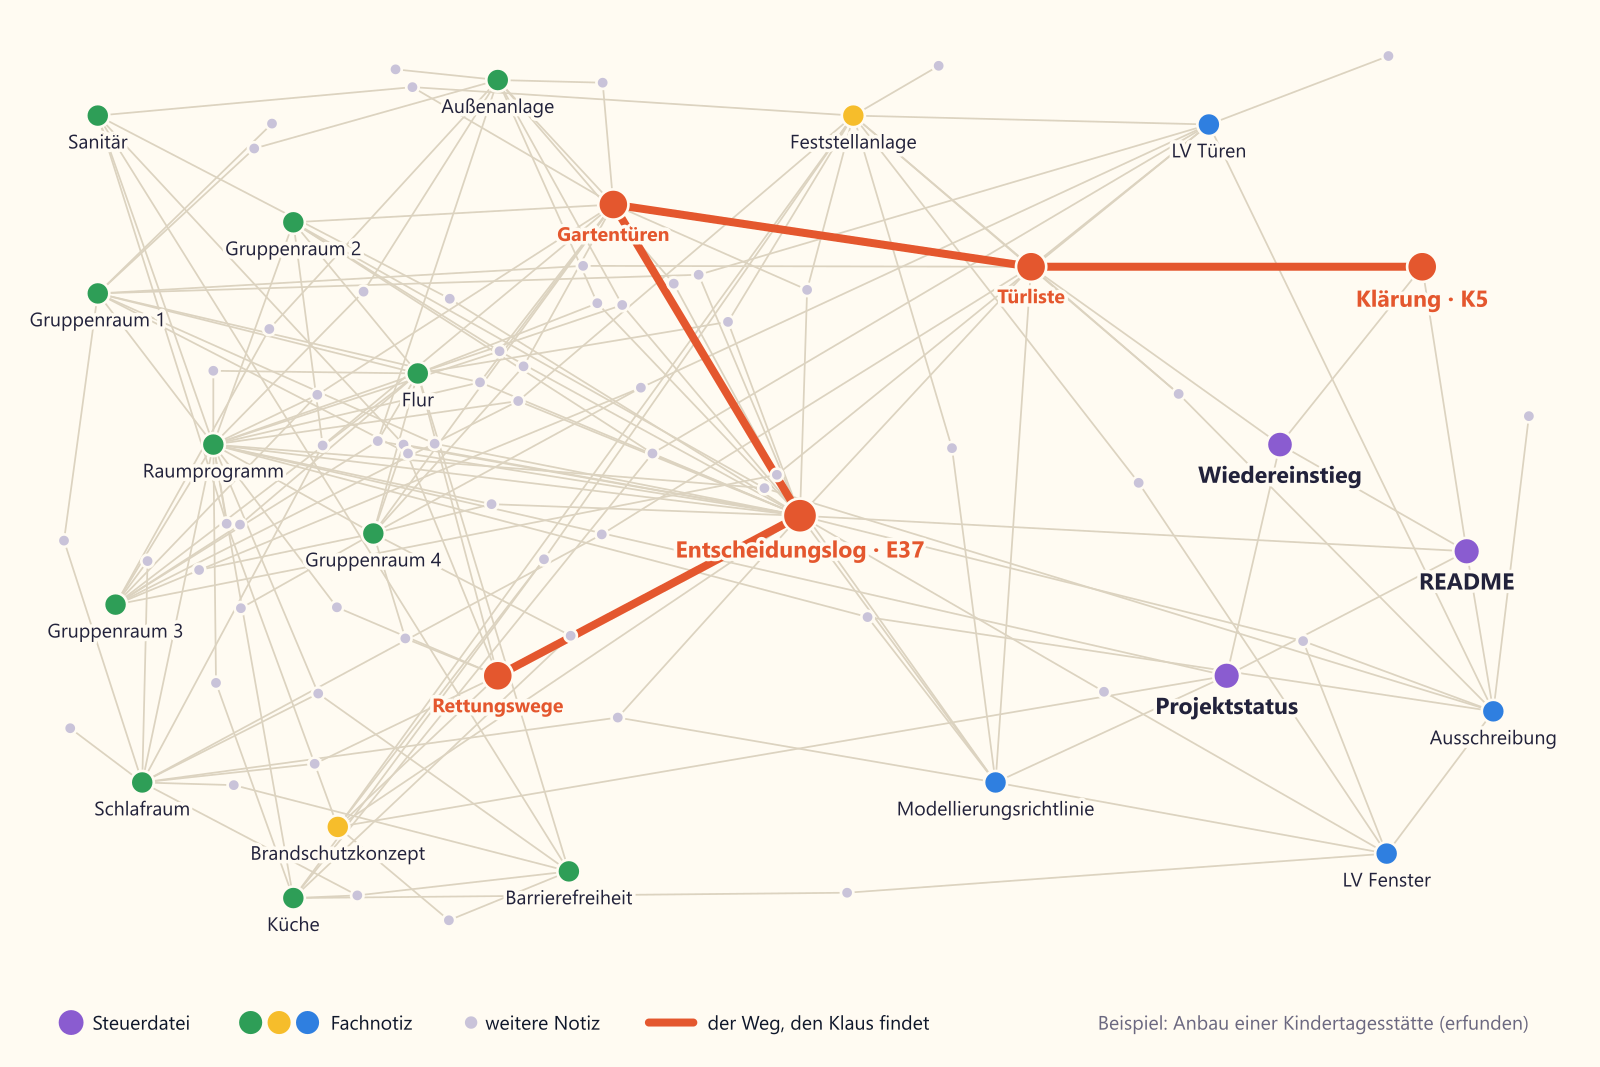
Ein Mensch verliert in einem solchen Netz den Faden, und zwar nicht aus Nachlässigkeit. Wer an der Türliste sitzt, denkt an Türen, nicht an einen Logeintrag, der Wochen alt ist. Die Verbindung ist da, aber sie ist vergessen.
Klaus verliert den Faden nicht, weil er ihn nicht im Kopf tragen muss. Er erinnert sich an E37 so wenig wie ich. Er sieht nach. Obsidian führt zu jeder Notiz die Rückverweise, also alle Notizen, die auf sie zeigen, und Klaus liest sie mit, sobald er eine Notiz anfasst. Dazu kommen die Volltextsuche und die Nummern: Ein „siehe E37" in einer Notiz ist eine Spur, der er in Sekunden folgt. So findet er Zusammenhänge zuverlässig wieder, die ich längst vergessen habe, und legt sie mir vor, bevor ich entscheide.
Das hat eine Bedingung, und sie liegt bei mir: Die Verbindung muss als Verweis geschrieben sein. Eine Entscheidung im Log nennt die Notizen, die sie betrifft, mit Link. Eine Klärungsfrage nennt den Logeintrag, auf dem sie aufbaut. Was im Graphen keine Linie hat, findet auch Klaus nur, wenn die Suche die richtigen Wörter trifft. Deshalb verlinkt er beim Schreiben mit, und deshalb gehört eine Regel in die README: Wer eine Notiz anfasst, liest ihre Rückverweise.
Die Regeln, die sich bewährt haben
Über die Zeit sind aus einzelnen Vorfällen Sätze geworden, die in jedem Sitzungsprompt stehen. Die meisten gelten für jeden, der mit einem Sprachmodell an etwas Größerem arbeitet.
Nachsehen schlägt schließen. Ein Sprachmodell ist sehr gut darin, aus dem, was es weiß, auf das zu schließen, was sein müsste. Das ist im Gespräch eine Stärke und in einem Projekt eine Gefahr. Ob ein Ordner existiert, ob ein Skript einen Pfad kennt, ob eine Datei geschrieben wurde: Das wird nachgesehen.
Eine Erklärung ist kein Beleg. Wenn ein Ergebnis überrascht, liefert Klaus in Sekunden eine einleuchtende Erklärung. Sie kann stimmen. Geglaubt wird sie erst, wenn sie an der Datei geprüft ist.
Nach dem Schreiben zurücklesen. Jede geschriebene Datei wird danach gelesen und ihre Größe gegen den Entwurf gehalten. Ein Schreibbefehl, der Erfolg meldet, hat getan, was er sollte, nicht unbedingt, was gemeint war.
Eine Sicherungskopie vor jeder Ersetzung per Skript. Mit vollem Pfad, nicht nur mit dem Dateinamen, und mit der erwarteten Zahl der Treffer. Diese Regel ist entstanden, nachdem am Ende einer Sitzung eine Steuerdatei verloren gegangen war und wiederhergestellt werden musste.
Kein Werkzeug ist fehlerhaft, solange sein Verhalten dokumentiert ist. Wenn ein Programm sich unerwartet verhält, liegt das meist an einer Annahme, nicht am Programm. Gelesen wird erst die Dokumentation und, wo vorhanden, der Quelltext der installierten Fassung.
Nicht geprüft sieht aus wie fehlerfrei. Eine Datei ohne Befund ist nicht dasselbe wie eine geprüfte Datei. Was nicht nachgesehen wurde, steht als nicht nachgesehen im Haltepunkt.
Wo nicht nachgesehen werden kann, ist „ich weiß es nicht" die richtige Auskunft. Das ist der Satz, den ich einem Sprachmodell am häufigsten beibringen musste, und der wertvollste.
Wo es nicht trägt
Ein Text, der nur die Vorzüge zeigt, wäre Werbung. Also das andere.
Klaus irrt mit Überzeugung. Er formuliert einen falschen Befund genauso sicher wie einen richtigen. Die Steuerdateien verhindern das nicht; sie sorgen nur dafür, dass ein Irrtum aufgeschrieben wird und beim nächsten Mal auffällt. Geprüft wird weiter von mir, und das letzte Wort habe ich.
Der Prompt veraltet trotzdem. Er wird am Ende jeder Sitzung ersetzt, und trotzdem kommt es vor, dass er etwas anderes sagt als die Dateien: weil eine Sitzung in einem anderen Werkzeug weiterging, weil ich etwas von Hand geändert habe, weil eine Sitzung abbrach. Die Regel die Datei ist der Stand fängt das ab, aber nur, wenn die Dateien selbst gepflegt sind.
Die Regeln wachsen schneller, als man sie liest. Jeder Anlass erzeugt einen Satz, und kaum einer wird wieder gestrichen. Eine README mit fünfzig Kilobyte Regeln liest auch ein Sprachmodell nicht mehr mit gleicher Aufmerksamkeit in jedem Absatz. Das Gegenmittel ist dasselbe wie in jedem Büro: gelegentlich aufräumen, zusammenfassen, Überholtes streichen. Ich mache das zu selten.
Der Aufbau kostet Zeit, bevor er Zeit spart. Die ersten Wochen fühlen sich an wie Bürokratie für einen einzelnen Menschen. Der Ertrag kommt mit der dritten Woche, mit dem zweiten Bereich und mit der ersten Sitzung, die nach einer Pause genau dort weitermacht, wo die letzte aufgehört hat.
Was im Vault steht, kann gelesen werden. Ein Sprachmodell mit Zugriff auf einen Ordner liest, was darin liegt. Was nicht hinein darf, darf auch nicht in den Vault, und was in einen öffentlichen Text darf, entscheidet eine Regel in der README, nicht das Sprachmodell.
Die Suche sieht nur, was als Text in einer Notiz steht. Eine Zahl, die nur in einer Zeichnung vorkommt, findet die Volltextsuche über Obsidian nicht, und eine Verbindung, die nie als Verweis geschrieben wurde, zeigt kein Graph. Wo der Faden nicht geschrieben ist, kann ihm auch Klaus nicht folgen. Einen Durchgang über einen ganzen Bestand lässt man deshalb über alle Dateiendungen laufen, nicht nur über die Notizen.
Und es hängt an fremden Werkzeugen. Obsidian, die Plugins, Blender, Bonsai und die MCP-Server ändern sich mit jeder Fassung. Ein Ablauf, der heute trägt, kann nach einem Update eine Werkzeugmeldung anders liefern. Deshalb gehört zu jedem Ergebnis, das auf einem Werkzeug beruht, die Fassungsnummer.
Wie man anfängt
Der kürzeste Weg ist dieser Text selbst. Kopieren Sie ihn in ein Sprachmodell Ihrer Wahl und schreiben Sie darunter: So etwas will ich auch. Dazu ein, zwei Sätze, worum es bei Ihnen geht: ein Bauprojekt, ein Unterrichtsfach, eine Abschlussarbeit. Das Sprachmodell kennt dann das Prinzip, fragt nach, was es für Ihren Fall wissen muss, und entwirft die ersten Dateien. Ist Ihr Notizordner schon angebunden, legt es sie gleich dort an; sonst kopieren Sie die Entwürfe selbst hinein.
Zwei Dinge nimmt es Ihnen nicht ab. Die Anbindung über MCP richten Sie auf Ihrem Rechner selbst ein, auch wenn das Sprachmodell Sie dabei Schritt für Schritt begleitet. Und die Regeln mit Anlass entstehen erst bei der Arbeit; ein Entwurf vom ersten Tag kann sie nicht vorwegnehmen.
Was am Anfang dabei herauskommen sollte, ist wenig. Drei Dateien reichen:
- Eine README mit den Spielregeln für den Bereich und der Lesereihenfolge für das Sprachmodell. Klein anfangen; sie wächst von selbst.
- Einen Wiedereinstieg mit genau einem Haltepunkt, den jede Sitzung am Ende neu schreibt.
- Eine Klärungsdatei für die Fragen, die nur Sie beantworten können, mit Nummern und mit der Regel, dass ein beantworteter Punkt entfernt wird.
Das Entscheidungslog kommt am besten vom ersten Tag an dazu, auch wenn es sich anfangs übertrieben anfühlt. Nach einem Monat ist es die Datei, in der Sie die Antwort auf die Frage finden, warum etwas so ist, wie es ist. Und den Sitzungsprompt legen Sie als Datei in den Vault, damit er am Ende der Sitzung ersetzt werden kann, statt in einem Gespräch zu verschwinden.
Alles Weitere, der Projektstatus, die Wurzeldatei, die Einbahnstraße zwischen Bereichen, kommt, sobald Sie es brauchen. Sie werden es merken: an der ersten Sitzung, die nicht weiß, wo sie steht.
Klaus ist dabei geblieben, was er von Anfang an war: geduldig, einfallsreich und ohne Gedächtnis. Zum Kollegen gemacht hat ihn nicht das Sprachmodell, sondern das, was er jeden Morgen auf dem Schreibtisch findet.
Stand: Werkstattbericht vom Oktober 2026, Fassungen am 15.10.2026 am Gerät ausgelesen: Claude von Anthropic in der Desktop-Anwendung (2.37337.1); Obsidian 1.14.4 mit dem Plugin Local REST API 5.1.0, angebunden über mcp-remote 0.14.3; Blender 5.2.0 LTS mit Bonsai 0.9.1 und Bonsai_mcp 0.2. Das Beispielprojekt ist erfunden; die Regeln stammen aus der eigenen Arbeit.


